Když se mluví o AI v testování, lidé hned řeší, kolik testovacích případů nástroj vytvoří, jak rychle to zvládne a jak málo informací k tomu potřebuje. Jen málokdo se ale zeptá na něco jiného. Kdo vlastně potvrdí, že se věc opravdu otestovala?
To není jen formalita. Když se v produkci něco pokazí, nikdo nezjišťuje, který model napsal test. Ptají se, kdo ho schválil a proč.
AI nativní QA proto potřebuje odpověď na tuto otázku, a touto odpovědí musí být konkrétní člověk. To znamená, že produkt musí být navržen tak, aby člověk mohl tuto odpověď opravdu dát. Fronta, kterou stačí jen odbavit, tuto odpověď nezajistí.
01
Schvalování lze dělat dvěma způsoby
Schválit návrh vygenerovaný pomocí AI může být skutečné rozhodnutí. Může to ale být i kliknutí, které jen vyčistí frontu.
Jde o zdokumentovaný vzorec. Nemá nic společného s povahou testera. Průzkum Bena Greena z roku 2022, který zkoumal 41 zásad vyžadujících lidský dohled nad algoritmy, odhalil dva jejich problémy. Lidé z velké části nejsou schopni vykonávat funkci dohledu, která jim byla svěřena. Samotný požadavek poskytuje „falešný pocit bezpečí při zavádění algoritmů“. Zároveň umožňuje dodavatelům a institucím „vyhýbat se odpovědnosti za škody způsobené algoritmy“ [1]. To, co bylo prezentováno a prodáváno jako řešení, byl samotný dohled.
Tento jev má jméno. Automatizační zkreslení je „bezmyšlenkovité přijímání rozhodnutí nebo doporučení učiněných systémem“ [2]. Nastává proto, že přijmout doporučení vyžaduje méně úsilí než jeho prověření. Výstup nahrazuje práci kontroly. Přitom právě tuto činnost měl systém člověku umožnit.
Software není výjimkou. Když AI opakovaně upravuje vlastní kód a nikdo mezi jednotlivými koly nekontroluje změny, zabezpečení se s každým dalším kolem zhoršuje. Studie Shukly, Joshiho a Syeda z roku 2025 zjistila, že už po pěti kolech „vylepšení“ od AI se počet kritických zranitelností zvýšil o 37,6 %. Autoři doporučují, aby mezi těmito koly vždy proběhla kontrola vývojářem [3]. Smyčka bez lidského zásahu se postupně vzdaluje původnímu cíli.
Viděl jsem ten samý vzorec i v QA. Zkušený a dobře fungující tým najednou dostal stovky testovacích případů, které čekaly na revizi. Nenapsali je testeři, ale lidé bez zkušeností s psaním testů. Struktura byla špatná, chyběly informace a očekávaný výsledek byl napsaný do kroku akce. Zkušení specialisté trávili hodiny opravováním cizí práce. Vrácení testů jejich autorům znamenalo jen další čekání. Nakonec je raději přepsali.
Velká část problému vzniká už samotným množstvím práce, kterou je potřeba zrevidovat. Případová studie kontrol revizí kódu v projektu Chromium OS zjistila, že s rostoucím rozsahem změny klesá pravděpodobnost, že se při revizi najde bezpečnostní defekt [4]. Revize testovacích případů sice není revize kódu, ale platí pro ni stejná věc. Lidská pozornost neroste spolu s rozsahem toho, co je potřeba při revizi zkontrolovat.
Skutečným rizikem AI v QA je tedy objem. Vytvoří tolik práce k revizi, že se revize změní na formalitu.
Nástroj, který tuto skutečnost ignoruje, problém nevyřešil. Jen ho posunul o krok dál.
02
Dvě opravy, které nefungují
Jsou tu dvě jasné možnosti. Žádná z nich ale nemá oporu v důkazech.
První možnost spočívá v tom, že odpovědnost přeneseme na osobu, která provádí revizi. Pokud osoba, která schvaluje výstup, ví, že za rozhodnutí nese odpovědnost, dalo by se čekat, že jej bude ověřovat pečlivěji. Kupfer a kolegové zkoumali tento předpoklad. Zjistili ale opak. Odpovědnost za rozhodnutí „nevedla k intenzivnějšímu ověřování ani k vyšší objektivní či subjektivní kvalitě rozhodnutí“ [2]. Samotná odpovědnost nevedla k pečlivějšímu ověřování výstupů.
Druhou možností je ukázat odůvodnění. Pokud systém vysvětlí, proč dospěl ke konkrétnímu výstupu, může jej člověk provádějící revizi posoudit. Výsledky se zde však rozcházejí. Je potřeba to zmínit místo citování té strany, která se zrovna hodí. Buçinca a kolegové zjistili, že přidání vysvětlení nesnižuje přehnanou důvěru a může ji dokonce zvýšit [5]. Existuje i opačný výsledek. Vysvětlení ji mohou snížit [6].
Rozhodující pro tento rozpor je důvod, proč se lidé vůbec rozhodnou zapojit. Podle druhého vysvětlení si lidé strategicky vybírají, zda se zapojí, nebo ne. Vysvětlení selhávají, pokud nedokážou dostatečně snížit náklady na ověřování [6]. Nejde tedy o to, zda lidé chtějí výstupy ověřovat. Důležité je, kolik úsilí je ověřování stojí.
Z toho vyplývají dvě věci. Do produktu má smysl zabudovat co nejjednodušší ověřování. Dále je potřeba zajistit, aby rozhodnutí nešlo obejít.
03
K rozhodnutí nestačí pouze tlačítko
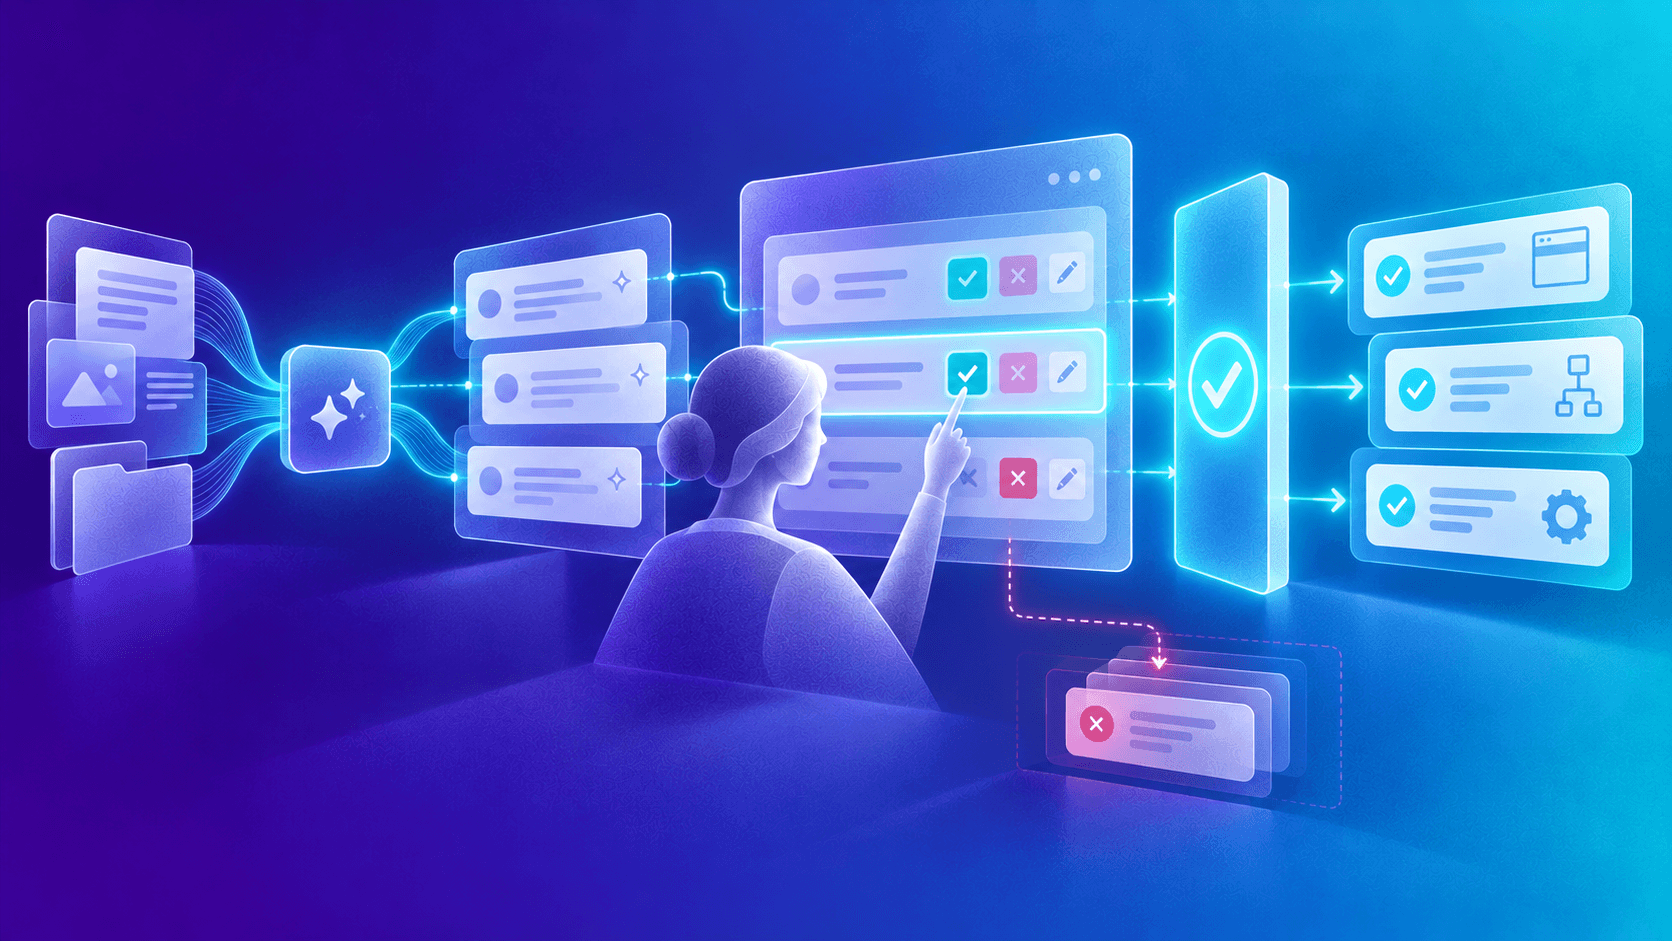
První návrh každého testovacího případu se generuje. Role modelu je úzce a pevně vymezená. Píše pouze návrh, ale o ničem nerozhoduje. Testuvion je postaven tak, aby tester mohl rozhodovat rychle a se skutečnou znalostí toho, o čem přesně rozhoduje. Většina následujících prvků buď usnadňuje ověřování, nebo zajišťuje, že rozhodnutí nelze obejít. Jeden z těchto prvků nedělá ani jedno. Pouze zaznamenává, kdo rozhodl.
Nejprve přicházejí zdrojové podklady. Teprve potom následují testovací případy. Testuvion spojí dokumentaci, kterou už máte, a označí rozpory i místa, kde informace chybí. Když dokumentace nestačí, projde samotnou aplikaci a doplní to, co v dokumentech není. Tester tak nemusí přebírat frontu návrhů podle zadání, které nikdo neověřil.
Každý krok má dohledatelný zdroj. U každého vygenerovaného kroku je vidět, odkud pochází. Tester proto porovnává návrh se zadáním vedle sebe, ne se svou pamětí.
O každém výstupu se rozhoduje zvlášť. Každý testovací případ můžete přijmout, zamítnout nebo upravit zvlášť. Není potřeba hromadně schvalovat všechny návrhy, které nikdo nečetl.
Auditní stopa uchovává informaci o tom, kdo rozhodl. Všechno, co se vytvoří, lze zpětně dohledat podle toho, z čeho to vycházelo, a také podle osoby, která to schválila.
Pod všemi čtyřmi prvky je ještě jeden, na kterém záleží nejvíc. Generované testovací případy začínají jako nerevidované. To znamená, že je nelze dál použít. Spustitelné testy se dají vytvořit jen z testovacích případů, které člověk zkontroloval a schválil. Server odmítne požadavek, pokud testovací případ není ve schváleném stavu. Schválení zde není kontrola na konci procesu. Je to chvíle, kdy se z návrhu stává schválený testovací případ, který se může dál používat.
Nic z toho práci testera neubírá. Jen ji zaměřuje na důležitější části procesu.
Ruční přepisování ze zadání do testovacích případů je práce, která nevyžaduje žádná rozhodnutí. Přepisujete informace z jednoho dokumentu do druhého a snažíte se cestou nic nevynechat. Nikdo se neptá na váš názor. Přesto to zabere hodiny. Když tuto práci odstraníte, zůstane to, co má být podstatou práce testera. Rozhodovat o tom, co je pokryto, co je rizikové a co chybí.
Má to svou cenu a nebylo by poctivé ji skrývat. Čím více dané řešení omezuje přehnanou důvěru lidí ve výstupy a doporučení systému, tím méně se jim líbí. Účastníci stejné studie dali nejméně příznivá subjektivní hodnocení návrhům, které přehnanou důvěru snížily nejvíc [5]. Schvalování jednotlivých položek je pomalejší než hromadné přijetí. Systém, který odmítá stavět na neschváleném návrhu, je v daném okamžiku překážka. Tato překážka není vedlejším účinkem návrhu. Je to jeho záměr.
Tester tím získá možnost kdykoli své rozhodnutí vysvětlit. Pokud zde schválíte testovací případ, můžete i po několika měsících snadno najít zdroj každého kroku i osobu, která ho schválila. Toto rozhodnutí pak můžete vysvětlit komukoli, kdo se na něj zeptá.
05
AI by neměla mít poslední slovo
AI v QA by neměla rozhodovat jako poslední. Měla by připravit první návrh.
To je celé sdělení. Generovaný testovací případ je jen návrh. Dokud jej neschválí konkrétní osoba, nelze jej použít. Produkt musí být navržen tak, aby tester mohl schválení udělit rychle. Tester musí své rozhodnutí umět obhájit. Jeho úsudek se pak stává nejcennější částí procesu. Už to není překážka, kterou se všichni snaží obejít.
Chcete se podívat, jak tento způsob práce funguje přímo s vaší dokumentací? Domluvte si ukázku.