Představujeme vizuální testování: odpovídá web návrhu ve Figmě?
Vizuální testování v Testuvionu porovná hotovou stránku s návrhem ve Figmě až po jednotlivé textové prvky. AI agent dostane výsledek kontroly, místo aby shodu s návrhem jen odhadoval podle screenshotu.
01
Představujeme vizuální testování: odpovídá web návrhu ve Figmě?
AI agent dokáže podle návrhu ve Figmě vytvořit webovou stránku za pár minut. Pořídí screenshot a prohlásí, že stránka odpovídá návrhu. Jenže v tom se může mýlit. Kdo má kontrolovat, jestli výsledná implementace skutečně odpovídá návrhu? Jasno v tom nebylo ani před příchodem AI agentů.
V Testuvionu proto právě zpřístupňujeme vizuální testování. Hotovou stránku porovná s návrhem ve Figmě a změří rozdíly u každého textového prvku i každé tenké linky. Vrátí výsledek kontroly a seznam nálezů seřazený podle důležitosti. Agent může kontrolu spustit přes MCP, nalezené rozdíly opravit a zkontrolovat stránku znovu. Takto pokračuje, dokud stránka nebude odpovídat návrhu.
02
TL;DR
Obvykle člověk nebo AI agent kontroluje stránku jen podle screenshotu. Taková kontrola ale může přehlédnout i záměrně provedenou změnu. V benchmarku DiffSpot z roku 2026 dostávalo třináct modelů dvojice snímků stejné webové stránky. V jedné verzi byla u jediného prvku změněna jedna vlastnost CSS, například výška řádku. Modely měly určit, co se změnilo. Nejlepší odhalil jen 40,7 % těchto změn [E5].
Rozdíly vůči návrhu se měří. Kontrola porovnává textové prvky, tenké linky a pixely jednotlivých sekcí s návrhem ve Figmě. Pro text, obrázky a layout používá různé limity. Tester tak může projít naměřené rozdíly, místo aby sám odhadoval, zda stránka návrhu odpovídá.
Agent si po každé opravě ověří výsledek. Přes MCP spustí kontrolu a zjistí, které nálezy vyřešil, které přibyly a které ještě zbývají. Funguje to i na localhostu. Stejnou kontrolu lze spustit z aplikace, naplánovat nebo zapojit do CI.
AI pomůže najít příčiny. Rozdíly seskupí podle příčin a doporučí opravit stránku, změnit návrh nebo nechat rozhodnout člověka.
Tímto způsobem jsme nechali AI agenty přestavět náš web. Používali přitom interní kontrolní nástroj, ze kterého dnešní vizuální testování vzniklo. Lidé na redesignu strávili v součtu méně než jeden pracovní den. Vývoj samotného kontrolního nástroje do toho nepočítáme.
03
Kdo má kontrolovat, jestli implementace odpovídá návrhu?
Zeptejte se v týmu, kdo má tuto kontrolu na starosti, a každý vám vysvětlí, proč to není právě jeho práce.
Testeři ověřují chování aplikace. Sylabus základní úrovně ISTQB mezi potřebnými dovednostmi uvádí znalosti testování, smysl pro detail, komunikaci, analytické myšlení a technické i oborové znalosti [E3]. Odbornost v designu na seznamu není. Rozpoznat o stupeň tučnější nadpis nebo o odstín světlejší dělicí linku vyžaduje cit pro design i znalost frontendu. V jedné diskusi to zaznělo přímo: „Máme i lidi z QA, ale ti hledají chyby a neočekávané chování. Připomínky k designu nedávají.“ [E10]
Kontrola tak často zůstane na těch, kdo si rozdílu všimnou. Designéři otevřou stránku vedle návrhu ve Figmě, pořizují screenshoty a vyznačují, co nesedí. Při každém vydání znovu. V jedné odpovědi na fóru to autor nazval „druhou prací designéra, o kterou si nikdo neřekl“ [E14]. Designér ze startupu napsal prostě: „Frontendové QA musím dělat sám.“ [E10] Designéři rozdíly vidí, ale nejsou testeři. V plánu se s jejich časem na testování málokdy počítá, takže kontrolují až pozdě, od oka a podle toho, kdy na to najdou čas.
Vývojářům mezitím zbývá průběžné ladění. Podle mé zkušenosti právě oni udělají většinu úprav: změní padding, obnoví stránku, porovnají výsledek a upravují znovu. Nástroje jim přitom málokdy řeknou, o kolik se stránka od návrhu ještě liší. Figma se na předávání návrhů do vývoje ptala v průzkumu mezi 943 designéry a frontendovými vývojáři. Prostor ke zlepšení v něm vidělo 91 % vývojářů a 92 % designérů [E12].
Podstatnou část tohoto kódu dnes píše AI agent. Problém s kontrolou tím ale nezmizel: i agent porovnává výsledek od oka. Designér z týmu používajícího Claude Code a Figma MCP to popsal takto: „Design QA bylo náročné už před AI, ale teď mi připadá desetkrát horší.“ [E15]
04
Shoda se starším screenshotem ještě neznamená shodu s návrhem
Screenshotový test porovnává aktuální snímek stránky s dříve schváleným snímkem, pixel po pixelu. Zjistí tak, jestli se stránka změnila. Nezjistí ale, jestli odpovídá návrhu. A správnost prvního referenčního screenshotu pořád musí někdo posoudit od oka.
Ani samotné porovnání screenshotů není bez problémů. Playwright ve své dokumentaci upozorňuje, že „vykreslování v prohlížeči se může lišit podle operačního systému, verze, nastavení, hardwaru, napájení (baterie nebo adaptér), režimu headless a dalších faktorů“ [E1]. Pro každý prohlížeč a platformu proto potřebujete vlastní referenční snímek [E2]. Jeden tým v diskusi popisoval, že se „topil ve false positive výsledcích“ [E16]. Jiný vývojář vzpomínal, že když test selhal, nejčastěji „někdo upravil očekávaný soubor nebo obrázek, aby test prošel“ [E16]. Pokud se z aktualizace referenčního snímku stane jen způsob, jak se zbavit červeného výsledku, test už nic neověřuje.
Podobný postup doporučuje Anthropic i AI agentům při práci na UI: „Pořiď screenshot výsledku a porovnej ho s originálem. Vypiš rozdíly a oprav je.“ [E7] Sami jsme tenhle postup používali. Do určité míry funguje. Jenže testovací nástroje se vyvíjejí desítky let a do AI tečou obrovské investice. A finální kontrola? Ukážeme modelu dva screenshoty a zeptáme se: „Tak co, sedí to?“ To jsme se daleko nedostali. S pouhým názorem se přece nemůžeme spokojit.
Benchmark DiffSpot z roku 2026 ukazuje, proč na tom záleží. Třináct špičkových modelů schopných pracovat s obrazem v něm porovnávalo dva snímky stejné webové stránky. V jedné verzi se změnila jediná vlastnost CSS u jediného prvku, například výška řádku. Úkolem modelů bylo změnu najít. Nejlepší zachytil 40,7 % skutečných změn a v nejtěžší kategorii zůstaly všechny modely pod 23 % [E5]. Při porovnávání hotové stránky s návrhem ve Figmě navíc vznikají snímky ve dvou různých rendererech a rozdílů je mnoho najednou. O benchmarku, který by přímo měřil tuto úlohu, nevíme. DiffSpot je nejbližší výzkum, který jsme našli.
Podobnou zkušenost popisují i lidé z praxe. Jeden vývojář ukázal Claude Code rozhraní s oříznutým textem a překrývajícími se prvky. Dostal odpověď: „Perfektní! Screenshot ukazuje, že XYZ funguje.“ [E11] Podle jedné agentury první pokus „zvládne zhruba 80 % správně, ale pak pokaždé strávíme 1 až 2 hodiny na komponentu hledáním rozdílů od oka a popisováním oprav pro AI“ [E13]. Kontrola tak znovu zůstala na člověku.
Stejná příručka přitom doporučuje dát Claudovi kontrolu s jasným výsledkem, zda prošla, nebo ne, aby mohl opravy průběžně ověřovat sám [E7]. Právě takový výsledek poskytuje vizuální testování při kontrole, zda stránka odpovídá návrhu.
05
Co se při porovnání s návrhem kontroluje
Původně naše testy ověřovaly jednotlivé hodnoty: mezery, padding, barvy a typografii. Procházely jimi ale i stránky s viditelnými chybami. Pokud nikdo nezapsal očekávanou šířku mezery mezi sloupci, nekontrolovala se. A tolerance určená pro zaokrouhlování barev připustila #fafafa tam, kde návrh obsahoval #ffffff. Každou opravu tak provázela debata nad screenshoty o tom, jestli kontrola měří správně.
Proto jsme přístup změnili. Referencí pro vizuální testování už nejsou ručně zapsané hodnoty, ale přímo návrh ve Figmě. Při každé kontrole se používá jedna konkrétní verze návrhu, která se během kontroly nemění. Nástroj nejdřív pořídí dva snímky stránky. Pokud nejsou stejné, kontrola skončí neúspěchem: stránka se ještě neustálila a místo skutečných odchylek by se měřil šum. Nad jedním stabilním snímkem pak proběhnou tři samostatné kontroly.
Rastr: liší se pixely v jednotlivých sekcích?
Každá sekce návrhu se porovná s odpovídající částí stránky. Odlišné pixely se seskupí a skupiny se roztřídí podle toho, k jakému obsahu patří: k textu, obrázku či videu, nebo k samotnému layoutu. Pro každou kategorii platí jiný limit. U layoutu stačí 8 odlišných pixelů, aby skupina neprošla. U obrázku je hranice 64 pixelů. U textu se posuzuje poměr odlišných pixelů k ploše vykreslených znaků.
Pravidla: jsou všechny linky na správném místě?
Každá tenká linka z návrhu, ať jde o ohraničení, oddělovač nebo podtržení, musí být i na stránce. Kontroluje se její poloha, tloušťka a barva. Zároveň nesmí přebývat žádná linka, která v návrhu není.
Text: odpovídá znění i typografie návrhu?
Ke každému textovému prvku v návrhu se najde odpovídající text na stránce. Kontroluje se jeho znění, rozměry a umístění, rodina písma, velikost a tloušťka písma, výška řádku, rozestupy mezi znaky, barva, zarovnání, počet řádků i ruční zalomení řádků. Místo neurčitého „nadpis je nějak moc tučný“ tak dostanete konkrétní nález: jakou tloušťku písma určuje návrh, jakou používá stránka a kterého prvku se rozdíl týká.
O výsledku kontroly rozhoduje měření. AI ho dostane až poté a nemůže ho změnit.
Pixel-perfect nelze chápat jako naprostou shodu všech pixelů. V našich porovnáních se poloha stejných znaků ve Figmě a Chromiu lišila zhruba o třetinu pixelu na slovo. Oba renderery také jinak vyhlazují hrany. Kontroly proto mají tolerance nastavené tak přísně, jak rozdíly ve vykreslování dovolují: půl pixelu pro polohu linky a desetinu pixelu pro velikost písma.
Kontroly jsme kalibrovali na sedmnácti chybách, které jsme záměrně vložili do vlastního webu. Například jsme zúžili mezeru mezi sloupci, smazali linku, nastavili tučnější nadpis nebo skryli slovo. Podle výsledků jsme pak kontroly doladili. Dvě ze sedmnácti chyb stále nezachycují spolehlivě: záměnu barvy plochy a posun barvy o dva stupně. Tyto případy evidujeme jako známá slabá místa. Tým může zvýšit sedm geometrických tolerancí, každou jen do stanoveného limitu. Tolerance barev zvýšit nelze.
Ne každá odchylka je chyba. Místo zástupného textu se mohou zobrazovat skutečná data. Nebo designér souhlasí s tím, že komponenta zůstane v implementované podobě. Tým může schválit jednotlivou odchylku i pravidlo pro celou kategorii nálezů na jedné obrazovce nebo v celé kontrole. Každé schválení musí mít zdůvodnění. Výsledek se pak označí jako shoda s výjimkami. Je tak vidět, že některé rozdíly byly schválené, ne že stránka návrhu beze zbytku odpovídá.
Tři případy, které jednoduché porovnání komplikují
Jeden vyšší prvek posune zbytek stránky. Sekce se porovnávají samostatně podle svého skutečného umístění. Pokud je hero sekce o 8 pixelů vyšší, nevznikne kvůli tomu záplava pixelových rozdílů ve všem pod ní. Kontrola přesto zaznamená, o kolik se následující sekce posunuly, a AI analýza pak pojmenuje společnou příčinu.
Obrázky potřebují jiné limity než text nebo layout. Rozdíly v místech s obrázkem, videem nebo SVG se hodnotí jako média s vlastním limitem. Obrázky se navíc vynechávají při určování barevného schématu stránky. Tmavá ilustrace tak nezpůsobí, že kontrola vyhodnotí světlou stránku jako tmavou.
Prohlížeč sází text jinak než Figma. U textu, jehož rozměry se ve Figmě přizpůsobují obsahu, se porovnávaná oblast určí podle skutečně vykreslených znaků. U textu s pevně danou šířkou je užší vykreslená oblast přípustná, pokud zůstane stejný počet řádků. Větší šířka nebo jiný počet řádků už kontrolou neprojde.
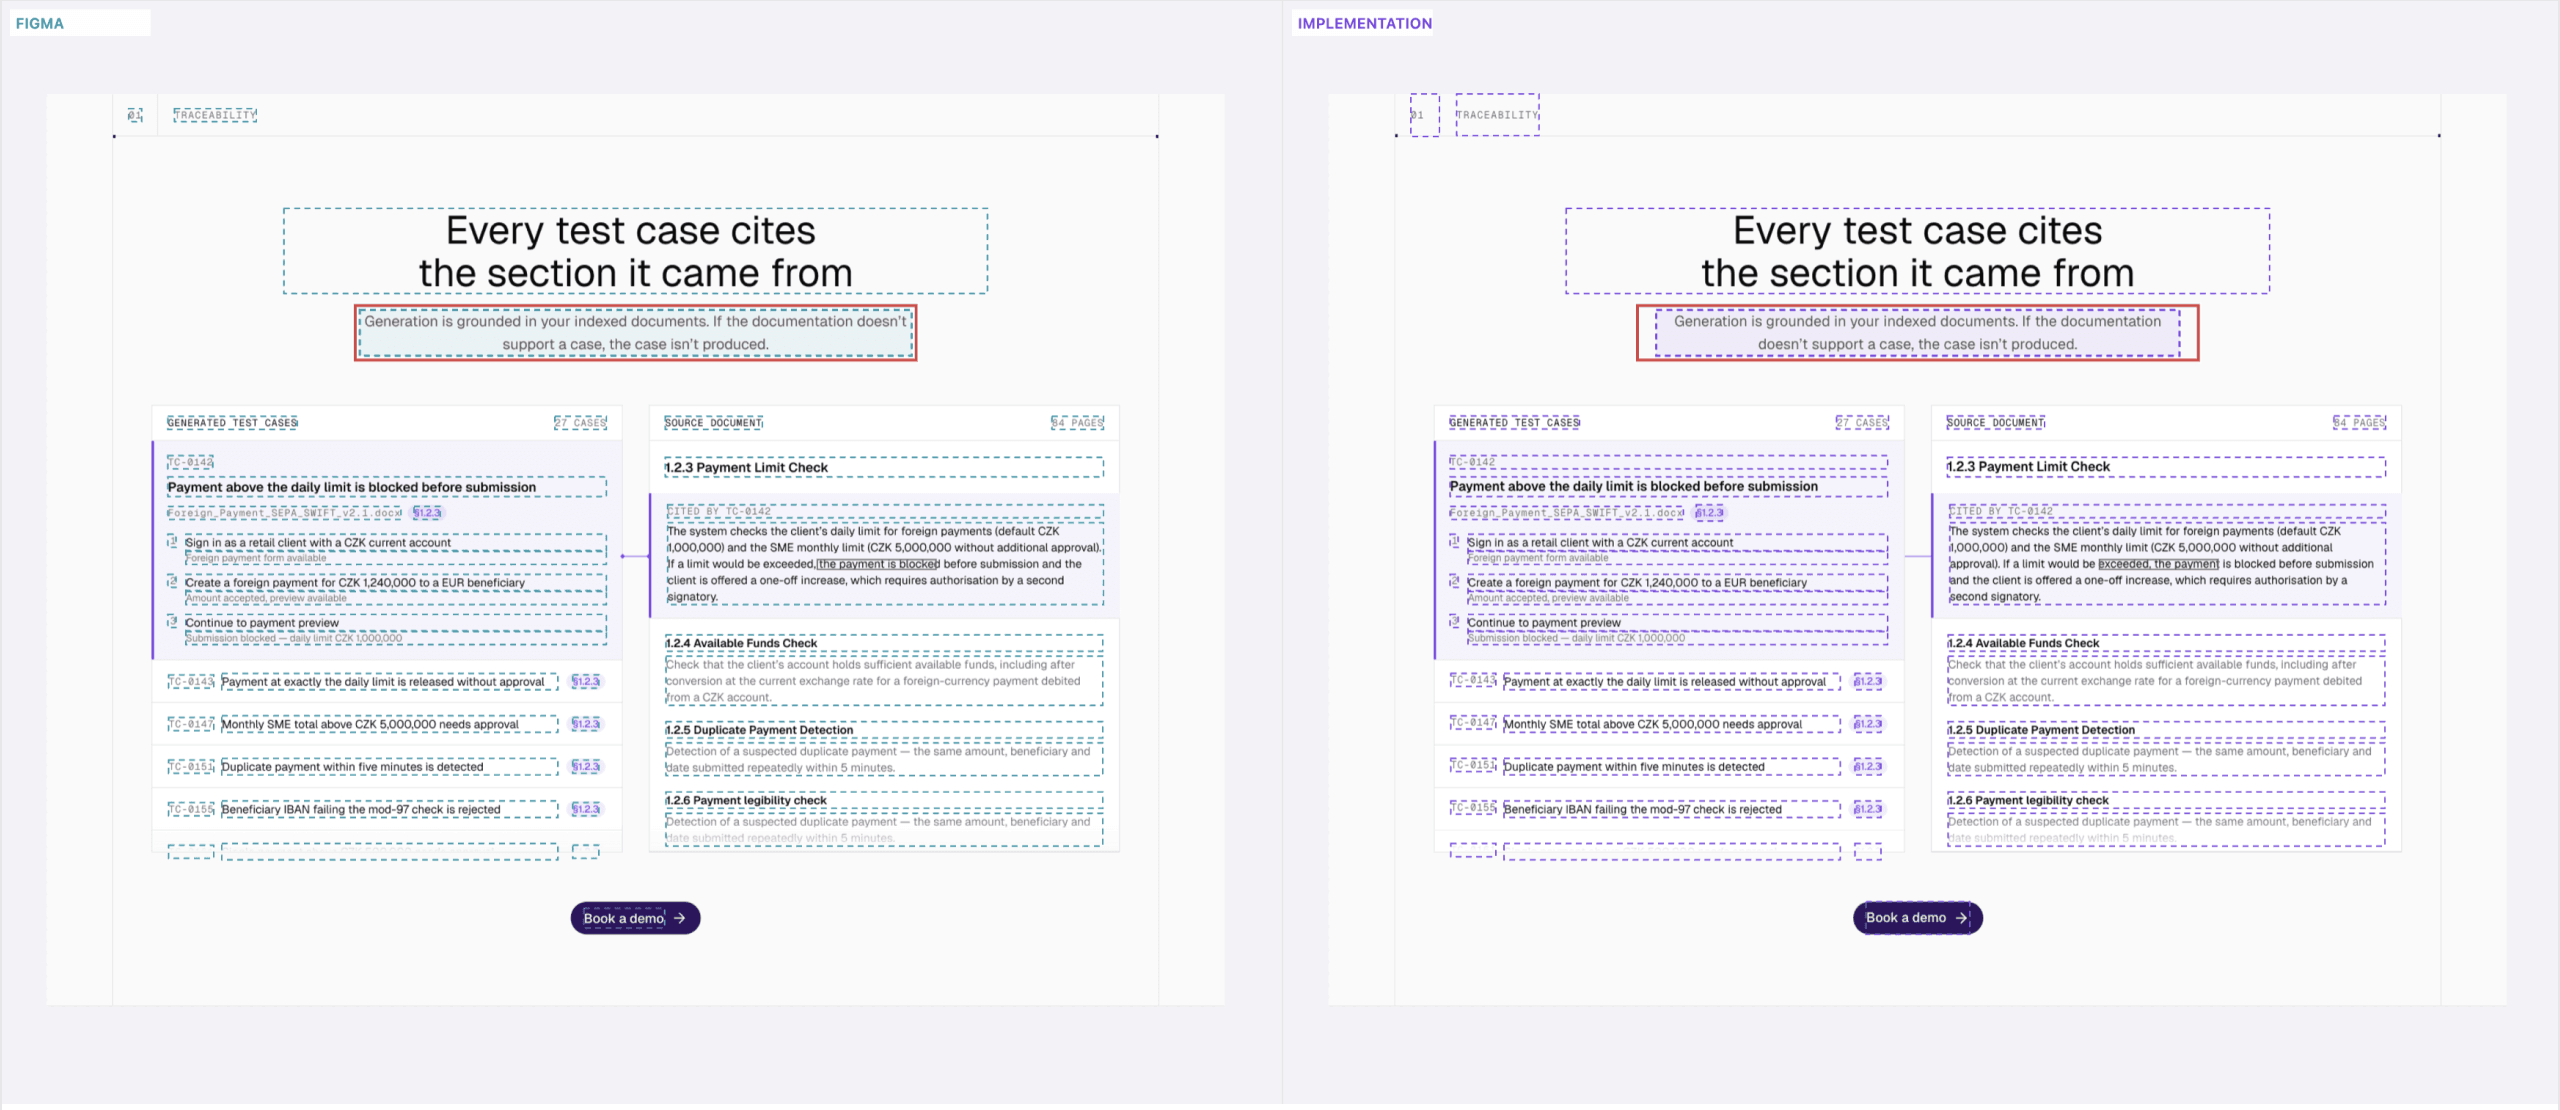
Vlevo návrh, vpravo stránka. Rámečky vyznačují textové prvky a linky, které kontrola spárovala. Červeně je označen jeden z nálezů: odstavec má v obou verzích dva řádky, ale text se zalamuje u jiného slova.
06
Jak jsme kontrolu zapojili do práce AI agentů na našem webu
Nejde o to, aby agent lépe viděl. Agent potřebuje spolehlivý výsledek kontroly, který nestojí na jeho vlastním úsudku. Anthropic ve svých doporučeních označuje zpětnou vazbu z externího systému za „zásadní“ v každém kroku [E17]. Podobně vycházejí i studie textových úloh zaměřených na uvažování: bez externí zpětné vazby mají modely s opravou vlastních chyb potíže, se spolehlivou zpětnou vazbou si vedou dobře [E20][E21]. Bez takové kontroly je podle příručky Claude Code „jediným dostupným signálem ‚vypadá to hotově‘“ [E19].
Anthropic také popisuje, že agenti sebejistě chválí vlastní práci, zejména u subjektivních úloh, jako je design [E18]. Tam se ale posuzovala estetická kvalita. Ověřit, jestli stránka odpovídá návrhu ve Figmě, je jiná úloha: konkrétní rozdíly lze změřit. Vizuální testování tuto kontrolu zpřístupňuje agentům přes MCP.
Agent spustí kontrolu obrazovky a v jedné odpovědi dostane výsledek, nejdůležitější nálezy i změny od předchozího běhu. Další nálezy si načte podle potřeby. Po každé opravě si nechá ukázat, co vyřešil, co nově přibylo a co ještě zbývá. Když úpravou paddingu zároveň rozhodí výšku řádku, uvidí jeden vyřešený nález a jeden nový. Nemusí znovu posuzovat screenshot, na kterém rozdíl skoro není vidět.
Kontrolovat lze i stránku, která během vývoje běží na localhostu přímo na počítači vývojáře. Konektor Testuvionu je malý program, který kontrolnímu nástroji zpřístupní lokální vývojový server. Agent tak může ověřit výsledek ještě před commitem. Ve sdíleném prostředí může běh získat označení „certifikovaný“: všechny kontroly proběhly v plném rozsahu, s celým referenčním návrhem a se všemi sekcemi přiřazenými k odpovídajícím částem stránky. Běh nad localhostem toto označení nedostane, protože ostatní nemohou zopakovat pořízení snímku z vývojového serveru na konkrétním notebooku. Localhost tedy slouží k průběžné kontrole při vývoji. Certifikovaný výsledek poskytne sdílené prostředí.
Takto vznikal redesign našeho webu. AI agenti implementovali jednotlivé stránky podle návrhů ve Figmě, spouštěli kontrolu a opravovali nalezené rozdíly. Používali interní nástroj, ze kterého dnešní vizuální testování vzniklo. Lidská práce od první stránky po poslední zabrala v součtu méně než jeden pracovní den. Šlo ale o stejný web, na kterém jsme kontroly kalibrovali. Do tohoto času nepočítáme vývoj kontrolního nástroje. Vznikal souběžně s redesignem a dál jsme ho zdokonalovali. Právě v něm byla hlavní technická práce.
Po dokončení práce agentů skončilo všech deset porovnání bez otevřených nálezů: osm stránek při šířce 1 440 pixelů a homepage při šířkách 320 a 1 920 pixelů. Zbývající odchylky byly schválené jednotlivě, pokaždé se zdůvodněním. Žádnou toleranci jsme kvůli tomu nezmírnili. Další změny webu už kontrolujeme přes hotovou funkci v Testuvionu a stejné MCP nástroje, které může používat agent v kterémkoli týmu.
07
Někdy je potřeba opravit návrh, ne kód
Při porovnávání se většinou předpokládá, že předloha je správná. Screenshotový test se řídí starším snímkem. Designér, který překrývá stránku návrhem, se řídí souborem z Figmy. Vizuální testování upozorní na rozdíl, ale neurčuje předem, na které straně je chyba. Pro autora návrhu je to důležitý rozdíl.
Během redesignu měla naše stránka s článkem 78 otevřených nálezů. Na první pohled to vypadalo na 78 chyb v kódu. Ve skutečnosti šlo o řetězový posun o 13 pixelů způsobený dvěma chybami v návrhu ve Figmě: citace nepřebírala výšku řádku z odstavce a nadpis na začátku odstavce se zalomil o řádek dřív. V zápatí homepage zase byla lokální úprava konkrétní instance o 8 pixelů, která se neměla přenášet do sdíleného zápatí. Ze všech tří problémů vznikly požadavky na designéra, ne změny kódu. Podobně dopadla i první chyba na stránce s ceníkem. Opravila se v návrhu a po přepnutí kontroly na novou verzi souboru se nález uzavřel. Kód se vůbec neměnil.
Tyto příčiny našli lidé, ještě než AI analýza existovala. Dnes už může změnu návrhu doporučit i analýza. U každé skupiny nálezů navrhne jednu ze tří možností: opravit stránku, změnit návrh nebo nechat rozhodnout člověka. Při jednom běhu například upozornila, že v zápatí stránky je text „All rights reserved.“, který v návrhu chybí. Rozhodnutí nechala na člověku: jestli tam text patří, má se doplnit do návrhu; jestli ne, má se ze stránky odstranit. Takové rozhodnutí závisí na požadavcích na produkt. Nástroj na to upozorní, místo aby hádal.
Designér tak nemusí zůstat u připomínky „nějak to nesedí“. Má konkrétní podklad: například že nadpis v návrhu používá o stupeň tenčí písmo než implementace. Nebo zjistí, že návrh stále obsahuje něco, co už nechceme. Každý prvek se při každém běhu zkontroluje podle stejných pravidel, bez ručního zakreslování červených šipek do screenshotů. Při přechodu na novou verzi návrhu se schválené odchylky u nezměněných částí zachovají. Znovu se schvalují jen tam, kde se návrh změnil.
08
AI vysvětluje, měření rozhoduje
I přesný seznam nálezů může být nepřehledný. Jedna kontrola naší homepage proti novější verzi návrhu skončila se 198 otevřenými rozdíly. Šlo o stejný běh jako v příkladu se zápatím výše. Než se pustíte do oprav, potřebujete zjistit, kolik samostatných problémů se za těmito 198 nálezy skrývá.
S orientací ve výsledcích pomáhá AI. Model schopný pracovat s obrazem dostane nálezy seřazené podle důležitosti. U nejdůležitějších má k dispozici také výřezy návrhu, stránky a vyznačených rozdílů. Vrátí shrnutí a nálezy seskupené podle příčin. V tomto běhu podrobně prošel nejdůležitější nálezy a rozdělil je do sedmi skupin.
Dvě skupiny se týkaly layoutu. Hero sekce byla o 8 pixelů vyšší, než měla být, a text srovnávací tabulky se zalomil na druhý řádek, čímž tabulka narostla o 28 pixelů. Třetí skupinu tvořily následky obou chyb: všechny další sekce se posunuly o 36 pixelů a o stejnou hodnotu narostla výška stránky. AI ve shrnutí připsala většinu ze 198 nálezů těmto dvěma příčinám. Čtvrtou skupinu způsobily podmínky pořízení snímku. Cookie banner překrýval řadu karet, takže jejich text kontrola vyhodnotila jako chybějící a text banneru jako přebývající. Zbývající tři skupiny se týkaly rozestupů v navigaci a dvou rozdílů v zápatí. V tomto konkrétním běhu trvalo měření asi minutu a čtyřicet sekund. Analýza stála přibližně 0,32 $.
Jedno doporučení ale bylo špatně. AI navrhla přidat do zápatí odkaz, který v návrhu je a na stránce chybí. Odkazovaná stránka je přitom záměrně skrytá. Tuto informaci o produktu analýza neměla.
Proto měření a interpretaci důsledně oddělujeme. Všechny nálezy i celkový výsledek určuje měření. AI nemůže upravit nález, změnit neshodu na shodu ani zasáhnout do certifikace. Každý její výstup je označený jako AI. Má usnadnit čtení výsledků, ne nahradit kontrolu. Analýzu lze pro jednotlivé kontroly vypnout. Jinak se spouští po každém dokončeném běhu, včetně plánovaných běhů a CI.
09
Co vizuální testování v Testuvionu spojuje
Nástroje pro jednotlivé části tohoto postupu už existují. Screenshotové testy odhalí změnu stránky. Pomocí překryvů může designér položit návrh přes stránku a rozdíly posoudit od oka. Jiné nástroje čtou vlastnosti prvků z Figmy a porovnávají je s prvky na stránce, ale vyhodnocení nechávají na uživateli. Další používají návrh z Figmy jako referenční obrázek a porovnávají ho s obrázkem stránky. Několik služeb pro vizuální testování dnes také zpřístupňuje výsledky přes MCP, takže si je může přečíst agent. Všechny tyto přístupy řeší část problému a týmy mají dobré důvody je používat.
Vizuální testování v Testuvionu je spojuje do jednoho postupu. Vychází přímo z návrhu a samostatně měří rozdíly v textu, linkách a pixelech. Tým určuje tolerance a schvaluje odchylky. Agent může kontrolu spouštět přímo na vývojářově počítači a analýza může doporučit, zda opravit stránku, nebo návrh.
Aby měla taková kontrola smysl, musí správně rozpoznat neshodu i shodu. Agent ji navíc potřebuje už při psaní kódu, dřív než za něj výsledek začne kontrolovat někdo další.
10
Co zatím podporujeme a jak začít
Vizuální testování právě zpřístupňujeme jako novou funkci. Zatím podporuje pouze návrhy z Figmy. Další zdroje, například Claude Design, plánujeme. Porovnání je navržené tak, aby šlo přidat jiný zdroj návrhu bez změny samotného způsobu měření.
Začnete odkazem na návrh ve Figmě. Zvolíte, jestli chcete kontrolovat celé stránky, nebo komponenty ve Storybooku, vyberete konkrétní návrhy a zadáte prostředí i cesty k jejich implementaci. Jednotlivé sekce se přiřadí k odpovídajícím částem stránky automaticky, pokud je přiřazení jednoznačné. Ve zbývajících případech ho potvrdí člověk. U stránek za přihlášením lze využít přihlašovací kroky z existujících testů projektu. Kontrolu pak spustíte přímo v Testuvionu, podle časového plánu, v CI nebo z AI agenta přes MCP. Přes konektor funguje i na vývojářově počítači.
Vývojář tak má agenta, který se nezastaví u dojmu „vypadá to hotově“. Hotovo má až tehdy, když stránka projde kontrolou. Tester prochází konkrétní nálezy, místo aby shodu s návrhem posuzoval od oka. Designér má při každém běhu zkontrolovaný svůj návrh a dostává podklady pro opravu kódu i designu. A týmy odpovědné za dodání produktu mohou kontrolu zapojit do CI a průběžného vývoje, ne ji řešit až před vydáním.
Článek vytvořil autor s pomocí AI
Každé číslo má dohledatelný původ: externí údaje vycházejí z publikací uvedených níže, naše vlastní z běhů mezi 16. a 30. zářím 2026 a údaj o lidské práci na redesignu z autorova vyjádření. AI analýza v příkladech běžela na modelu Claude Sonnet 5. Úvodní ilustraci vytvořil obrazový model GPT od OpenAI. Přehled dalších nástrojů jsme sestavili 1. října 2026.
CTA
Pixel-perfect implementace za zlomek nákladů
Ušetřete testerům, vývojářům i designérům hodiny strávené porovnáváním screenshotů, ať se mohou věnovat práci, na které opravdu záleží.
Jak jsme postavili hlasového asistenta, který zachytí projektové znalosti, jež se do dokumentace nikdy nedostanou, a jaké tři podmínky musí splnit, aby mohl bezpečně běžet v produkční aplikaci: jedná pod identitou uživatele, má k dispozici osmnáct nástrojů pouze pro čtení a jeho nástroje hlásí jen to, co rozhraní skutečně provedlo.
Lidský dohled nad AI většinou selhává a výzkum říká proč: samotná odpovědnost lidi nepřiměje kontrolovat a ukazování odůvodnění je sporné. Zůstávají náklady na ověřování a to, zda lze rozhodnutí přeskočit. To je argument pro to, aby se schválení testerem považovalo za okamžik, kdy generovaný testovací případ získá oprávnění, nikoli za pojistku přidanou na konci.